

Foto: chris robert via Unsplash
Wie in het Nederlands met een AI-model praat, betaalt meer dan wie dezelfde vraag in het Engels stelt. Hoeveel meer? Dat hebben wij zelf gemeten. Exact dezelfde 1.004 nieuwszinnen kosten in het Nederlands 25 procent meer tokens bij de modellen van OpenAI, ruim 50 procent meer bij Claude van Anthropic en bijna 59 procent meer bij Llama van Meta. Voor bedrijven die AI gebruiken in het Nederlands, is dat een verborgen toeslag op elke vraag.
Aanleiding is een onderzoek van de Coalition for Language Equity in AI Research (CLEAR), waar ook Bright over schreef. Volgens dat onderzoek kosten sommige talen 1,5 tot 5 keer zoveel tokens als Engels. De onderzoekers noemen het een tokenizer tax: een belasting voor wie geen Engels spreekt. Een concreet cijfer voor het Nederlands noemden ze niet. Daarom zochten wij het zelf uit.
Wat zijn tokens, en waarom kost Nederlands er meer?
AI-modellen lezen geen woorden, maar tokens: stukjes tekst van een paar letters, een heel woord of een leesteken. Wie een AI-model via een API gebruikt, betaalt per token. En ook bij een abonnement als ChatGPT Plus of Claude Pro tellen tokens mee: je limieten raken sneller vol en er past minder tekst in één gesprek.
Een AI-model leert bij de training welke stukjes tekst vaak voorkomen. Omdat het grootste deel van de trainingsdata Engels is, kent een model veel Engelse woorden als één token. Een Nederlands woord als onderzoeksresultaten wordt vaker in losse stukjes geknipt. Lange samenstellingen, die het Nederlands veel heeft, maken het extra duur.
Onze meting: Nederlands kost 25 tot 59 procent meer
Voor een eerlijke vergelijking gebruikten we SIB-200, een openbare verzameling van 1.004 korte nieuwszinnen die door professionele vertalers in meer dan 200 talen is vertaald. Zo vergelijk je precies dezelfde inhoud. Die zinnen lieten we tellen door de tokenizers van acht AI-modellen:
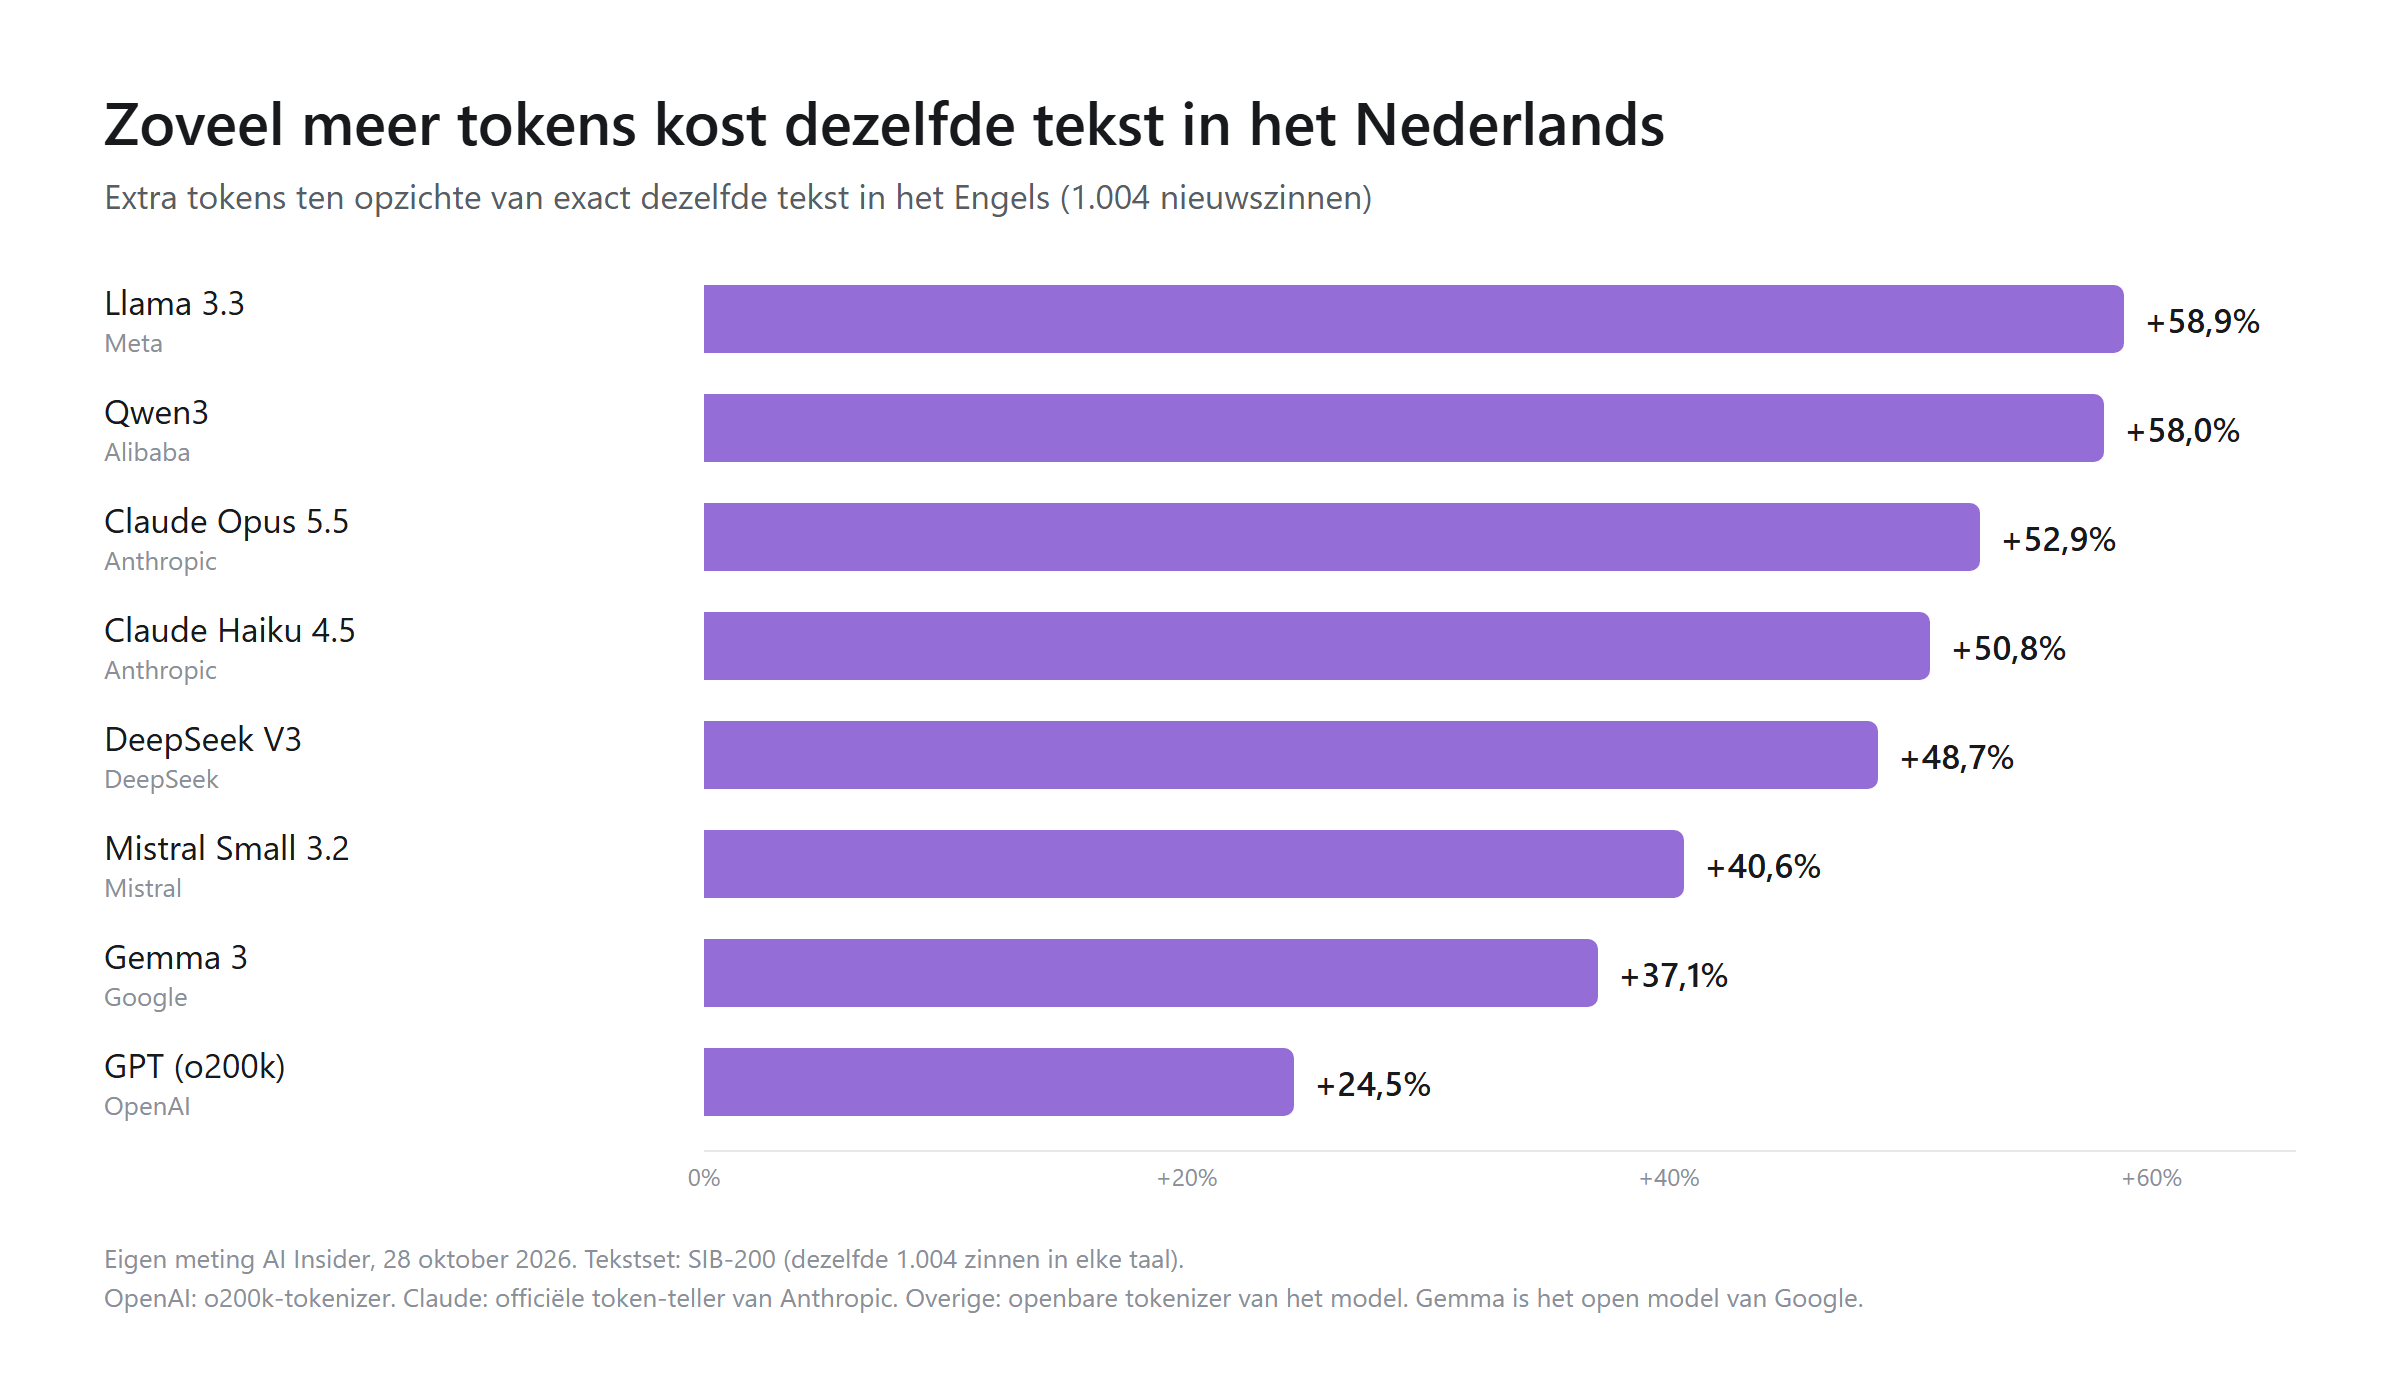
- OpenAI (ChatGPT, GPT-modellen): de Nederlandse tekst kost 24,5 procent meer tokens dan de Engelse. OpenAI doet het daarmee het best van alle gemeten modellen.
- Gemma 3 van Google: 37,1 procent meer. Gemini zelf kunnen we niet rechtstreeks meten; Gemma is het open model van hetzelfde bedrijf.
- Mistral Small 3.2: 40,6 procent meer.
- Claude van Anthropic: 50,8 procent meer bij Claude Haiku 4.5 en 52,9 procent bij het topmodel Claude Opus 5.5. Dat meten we met de officiële token-teller van Anthropic.
- DeepSeek V3: 48,7 procent meer.
- Qwen3 van Alibaba en Llama 3.3 van Meta: de duurste, met 58,0 en 58,9 procent meer.
Ter vergelijking: Duits en Frans zitten in dezelfde orde van grootte. Welke van de drie talen het duurst is, verschilt per model. Bij Claude kost Duits zelfs meer dan 70 procent extra.
Een opvallende bijvangst: Claude Opus 5.5 gebruikt voor dezelfde Engelse tekst ook veel meer tokens dan Claude Haiku 4.5, namelijk 42.304 tegen 29.293. De nieuwe Opus telt dus anders, ongeacht de taal. Wie de prijzen van modellen vergelijkt, moet daarom niet alleen naar de prijs per token kijken, maar ook naar hoeveel tokens een model voor dezelfde tekst nodig heeft.
Een ander, onafhankelijk onderzoek naar 25 Europese talen komt op een vergelijkbaar beeld uit. Nederlands kost daar gemiddeld 1,67 tokens per woord, tegen 1,23 voor Engels. Daarmee zit het Nederlands in de Europese middenmoot: duurder dan Engels, Spaans en Frans, goedkoper dan Duits en de Slavische talen.
Wat betekent dat in euro’s?
Bij een abonnement merk je het vooral aan je limieten: wie in het Nederlands werkt, zit eerder aan het maximum van zijn gesprekken. Bij gebruik via een API zie je het direct op de rekening. Een rekenvoorbeeld:
- Een bedrijf dat via Claude voor 1.000 euro per maand aan Engelse tekst laat verwerken, betaalt voor dezelfde tekst in het Nederlands zo’n 1.500 euro.
- Bij OpenAI zou datzelfde bedrijf voor de Nederlandse versie ongeveer 1.250 euro betalen.
Ook het geheugen van een model raakt sneller vol. Een model dat 200.000 tokens tegelijk kan lezen, kan in het Nederlands ongeveer een derde minder tekst verwerken dan in het Engels.
Welk AI-model is het best in het Nederlands?
Goedkoper is niet automatisch beter. Hoe goed een model Nederlands begrijpt, wordt gemeten door de Europese benchmark EuroEval, die modellen test op negen Nederlandse taken, zoals het herkennen van sentiment in boekrecensies, kennis over Nederland en het herschrijven van tekst in eenvoudige taal. Volgens een analyse van DataNorth van de EuroEval-cijfers (september 2026) ziet het beeld er zo uit:
- Gemini van Google staat bovenaan het Nederlandse klassement, en weet vooral veel over Nederland zelf.
- GPT van OpenAI volgt op de derde plaats, met sterke taalvaardigheid en redelijke kennis van Nederland.
- Claude van Anthropic is net zo goed in het begrijpen van Nederlandse tekst, maar scoort in de test (met Claude Sonnet 4.5) duidelijk lager op specifieke kennis over Nederland.
- Open modellen als Qwen en Gemma volgen dicht daarachter.
- Het Europese EuroLLM scoort het best van allemaal op het herschrijven in eenvoudige taal.
Het Nederlandse model GPT-NL, ontwikkeld door TNO, het Nederlands Forensisch Instituut en SURF, is nog niet breed beschikbaar.
De belangrijkste les uit die vergelijking: in het begrijpen en schrijven van Nederlands liggen de topmodellen dicht bij elkaar. De echte verschillen zitten in kennis over Nederland, en in de kosten.
Moet je dan maar Engels praten tegen AI?
Niet per se. Een paar praktische tips:
- Schrijf vaste instructies in het Engels, en laat het antwoord in het Nederlands. Vooral voor bedrijven die dezelfde lange instructie bij elke vraag meesturen, scheelt dat al snel. Zet erbij: “Answer in Dutch.”
- Vergelijk modellen op kosten per taak, niet per token. Een model met een lagere prijs per token kan voor Nederlandse tekst alsnog duurder uitvallen.
- Houd de tekst die je meestuurt kort. Stuur alleen de relevante delen van een document mee, in plaats van alles.
- Gebruik caching. Veel aanbieders rekenen minder voor tekst die je vaker meestuurt, zoals een vaste instructie.
- Kies voor Nederlandse kennis het model dat het best scoort, en controleer feiten over Nederland altijd zelf.
Voor de meeste mensen met een abonnement is Nederlands blijven praten prima. Maar wie AI op grote schaal inzet, voor een klantenservice, vertalingen of het verwerken van documenten, doet er goed aan deze verborgen toeslag mee te rekenen. Meer over de prijzen van ChatGPT lees je in ons overzicht Wat kost ChatGPT?, en hoe de prijzen van AI-abonnementen stijgen, lees je hier.
Zo hebben we gemeten
We gebruikten de 1.004 zinnen uit SIB-200 die in het Engels, Nederlands, Duits en Frans beschikbaar zijn. Voor OpenAI gebruikten we de o200k-tokenizer, die de huidige GPT-modellen gebruiken. Voor Claude gebruikten we de officiële token-teller van Anthropic, met Claude Opus 5.5 en Claude Haiku 4.5. Voor Llama 3.3, Qwen3, DeepSeek V3, Mistral Small 3.2 en Gemma 3 gebruikten we de openbare tokenizers van die modellen. Gemini zelf konden we niet meten. Het gaat om korte nieuwsteksten: bij andere soorten tekst, zoals juridische documenten of programmeercode, kunnen de verhoudingen iets anders uitvallen.
Bronnen: eigen meting AI Insider (28 oktober 2026); Coalition for Language Equity in AI Research, “The Tokenizer Tax”, via Bright (27 oktober 2026); Ovcharov, “The Tokenizer Tax Across 24 European Languages”, arXiv (mei 2026); EuroEval via DataNorth (oktober 2026); SIB-200 (Adelani e.a.).