

In het kort
Een MCP-server is een koppeling waarmee een AI-assistent zoals Claude zelf gegevens kan opvragen uit jouw systemen. Je kunt er zelf een bouwen. Wij bij AI Insider deden dat voor ons eigen datawarehouse, zodat elke collega in gewone taal vragen kan stellen over onze cijfers, zonder SQL en zonder iemand te storen. Het hele project kostte één werkdag. De koppeling zelf werkte na twee uur. De andere vijf uur gingen op aan het uitleggen van onze data en het meten van de antwoorden, en precies dat bracht ons van 16 naar 31 van de 31 goede antwoorden.
In dit artikel lees je hoe we het bouwden, welke keuzes we maakten en wat er misging. Je krijgt ook een checklist om het zelf te doen. Het stappenplan in het kort:
- Eerst veilig, dan pas nuttig
- Meet voordat je gaat documenteren
- Documentatie is het eigenlijke product
- Zorg dat het bij blijft
Wat is een MCP-server?
MCP (Model Context Protocol) is een open standaard waarmee AI-assistenten met externe systemen praten. Een MCP-server biedt een paar tools aan, bijvoorbeeld “lees deze tabel” of “voer deze query uit”. Claude besluit zelf wanneer hij welke tool gebruikt. Vergelijk het met een stekkerdoos: je bouwt de koppeling één keer, en daarna kan elke MCP-geschikte assistent erop aansluiten.
In Claude heet zo’n koppeling een connector. Bekende voorbeelden zijn de connectors om Claude aan Gmail te koppelen of aan Outlook. In een Claude Team-account kan een beheerder ook een eigen connector toevoegen, waarna elke collega hem kan gebruiken.
Waarom een eigen MCP-server, en niet de standaard Supabase- of Postgres-MCP?
Al onze cijfers komen samen in één datawarehouse: een Postgres-database bij Supabase, met een dashboard erbovenop voor artikelen, verkeer uit Google, affiliate-inkomsten en facturatie. Elke vraag die net buiten dat dashboard viel, kwam bij twee mensen terecht. Wij wilden dat elke collega zulke vragen zelf in Claude kan stellen.
Er bestaan al kant-en-klare MCP-servers voor databases, ook van Supabase zelf. Die zijn gemaakt als hulpmiddel voor ontwikkelaars: je logt in met je eigen Supabase-account en de AI werkt met jouw ontwikkelaarsrechten. Supabase raadt zelf af om zo’n koppeling zomaar op een productiedatabase aan te sluiten. Voor een heel team is dat omslachtig: iedere collega heeft een eigen account en toegang tot de database nodig, en moet zelf een koppeling instellen. Dat is lastig bij te houden, en riskant als iemand per ongeluk ook schrijfrechten krijgt.
Daarom bouwden we één eigen connector voor het hele team. Daarmee:
- logt iedereen in met zijn werkaccount, zonder losse database-accounts;
- kan niemand iets wijzigen, omdat de database zelf alleen lezen toestaat;
- blijven wachtwoorden en sleutels onzichtbaar, ook in tabellen die later bijkomen;
- werkt iedereen met dezelfde cijfers en dezelfde uitleg, omdat de connector Claude onze eigen documentatie meegeeft;
- staat het antwoord er binnen een minuut, zonder te wachten op die ene collega die met AI in de database kan.
Claude kan daarnaast de code van het warehouse lezen. Dan zegt hij niet alleen wat een getal is, maar ook hoe het berekend wordt.
Voorbeeldvragen die collega’s nu zelf stellen
- “Hoeveel nieuwsartikelen publiceerden we vorige maand, en hoeveel clicks kregen ze uit Google?”
- “Waarom wijkt dit getal af van wat we in Search Console zien?”
- “Welke artikelen verloren de afgelopen drie maanden het meeste verkeer uit Google?”
- “Welke pagina’s krijgen veel vertoningen maar weinig clicks?”
- “Welke artikelen zijn al een jaar niet bijgewerkt, maar trekken nog wel bezoekers?”
Stap 1: eerst veilig, dan pas nuttig
Bij een MCP-server voor een database, zoals Postgres of Supabase, zie je grofweg drie aanpakken. Microsoft zet ze in een blogpost over MCP-servers voor databases goed naast elkaar:
| Aanpak | Voordeel | Nadeel |
|---|---|---|
| Vrije SQL (lezen én schrijven) | Kan alles | Eén verkeerde query en je data is weg |
| Alleen-lezen SQL | Elke vraag kan, niets kan stuk | Het model moet je database begrijpen |
| Vaste querysjablonen | Voorspelbaar en veilig | Alleen de vragen die je vooraf bedacht |
Wij kozen alleen-lezen SQL. De vragen van collega’s zijn niet te voorspellen, dus sjablonen zouden steeds tekortschieten. Het nadeel (het model moet je database begrijpen) bleek uiteindelijk het eigenlijke werk. Daarover meer in stap 3.
De veiligheid zit niet in de AI, maar in de database zelf:
- Een eigen databasegebruiker met alleen leesrechten. Ook als Claude een
DELETEzou proberen, weigert de database. - Een time-out van 15 seconden per query en maximaal 1.000 rijen, zodat één zware vraag de database niet platlegt.
- Geheimen afgeschermd op databaseniveau. Tabellen met tokens of wachtwoorden krijgen een extra regel (een restrictive row level security policy) die de connector-gebruiker niets laat zien, ongeacht wat hij vraagt.
-- Generiek voorbeeld: deze tabel is onzichtbaar voor de connector-rol
CREATE POLICY geen_geheimen ON public.api_tokens
  AS RESTRICTIVE FOR SELECT TO ai_reader
  USING (false);
Inloggen gaat via OAuth: de standaard die Claude verwacht voor connectors. Collega’s loggen in met hetzelfde Google-account als voor het dashboard, en de connector weet daardoor wie er vraagt. Elke vraag wordt gelogd, inclusief hoe lang hij duurde en of hij misging.
Stap 2: meet voordat je gaat documenteren
Dit is de stap die we in geen enkele tutorial tegenkwamen, en volgens ons de belangrijkste.
Toen de connector werkte, hebben we hem niet meteen uitgerold. We stelden eerst 25 testvragen op, zoals collega’s uit verschillende hoeken van het team ze zouden stellen: over cijfers, over hoe een proces werkt en over wat een automatisering precies doet. Elke vraag hadden we zelf al eerder beantwoord, dus we wisten wat het juiste antwoord was. Daarna lieten we Claude ze allemaal beantwoorden en beoordeelden we elk antwoord als goed, deels goed of onvoldoende.
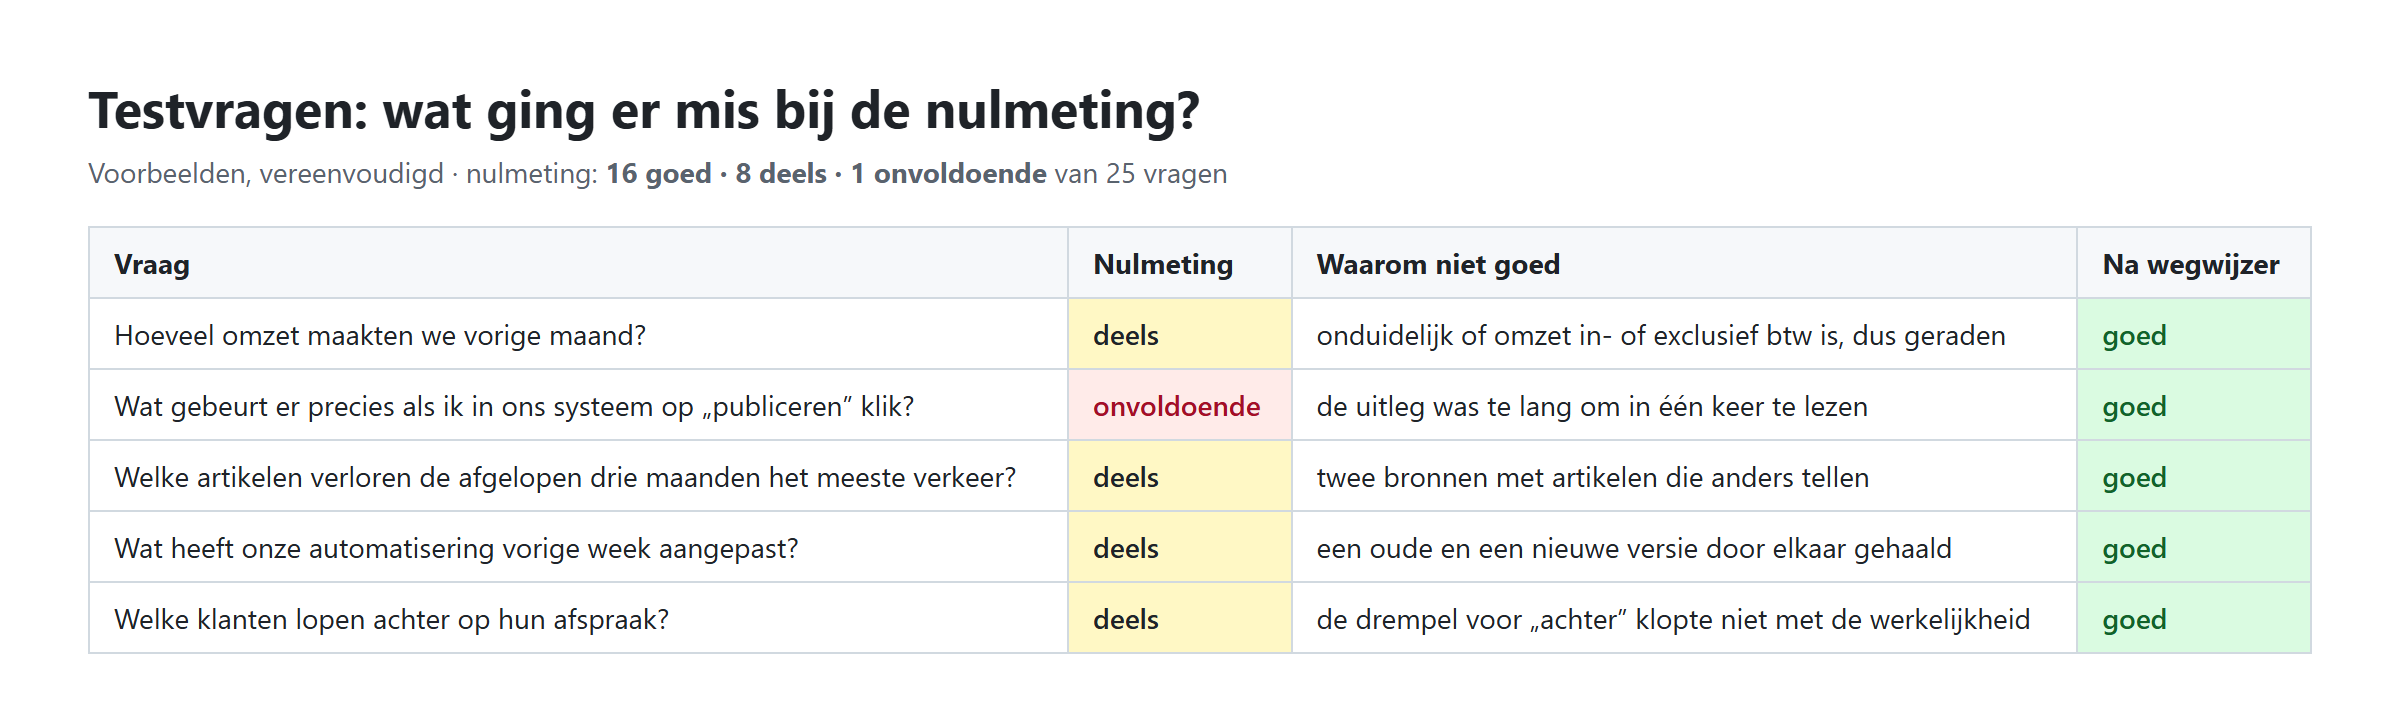
De nulmeting: 16 goed, 8 deels goed, 1 onvoldoende. Claude had gemiddeld 4,6 tool-aanroepen per vraag nodig.
Dat klinkt redelijk, maar “deels goed” is in de praktijk gevaarlijk. Het antwoord ziet er overtuigend uit, maar de collega die het leest weet niet dat het niet klopt. De fouten hadden steeds dezelfde oorzaak: Claude moest raden. Welke van twee vergelijkbare tabellen is de juiste? Telt een artikel dat we later offline haalden nog mee? Is “omzet” inclusief of exclusief btw? Dat staat nergens in de database, dat zit in de hoofden van het team.
Stap 3: documentatie is het eigenlijke product
We stopten dus met bouwen en begonnen met uitleggen. Op twee plekken:
1. In de database zelf. Elke tabel en de belangrijkste kolommen kregen een omschrijving (COMMENT ON in Postgres): wat is één rij, waar komt het vandaan, wanneer gebruik je hem. De connector toont die omschrijvingen bij tabellen en beschrijf_tabel, dus Claude ziet ze precies op het moment dat hij een tabel kiest. In één ronde voegden we er ruim 200 toe.
2. Een “wegwijzer” in de repository. Een set pagina’s in gewone taal, bedoeld voor collega’s én voor Claude:
- Begrippen: hoe rekenen wij omzet, wat telt als “gepubliceerd”, welke datum gebruiken we.
- Valkuilen: fouten die je makkelijk maakt, met de juiste aanpak ernaast.
- Een pagina per onderwerp (zoals content, verkeer en facturatie) met een diagram en geteste voorbeeldquery’s.
- Een pagina per systeem, ook voor onze automatiseringen: wat doet het, waarop beslist het en waarom is het zo gebouwd.
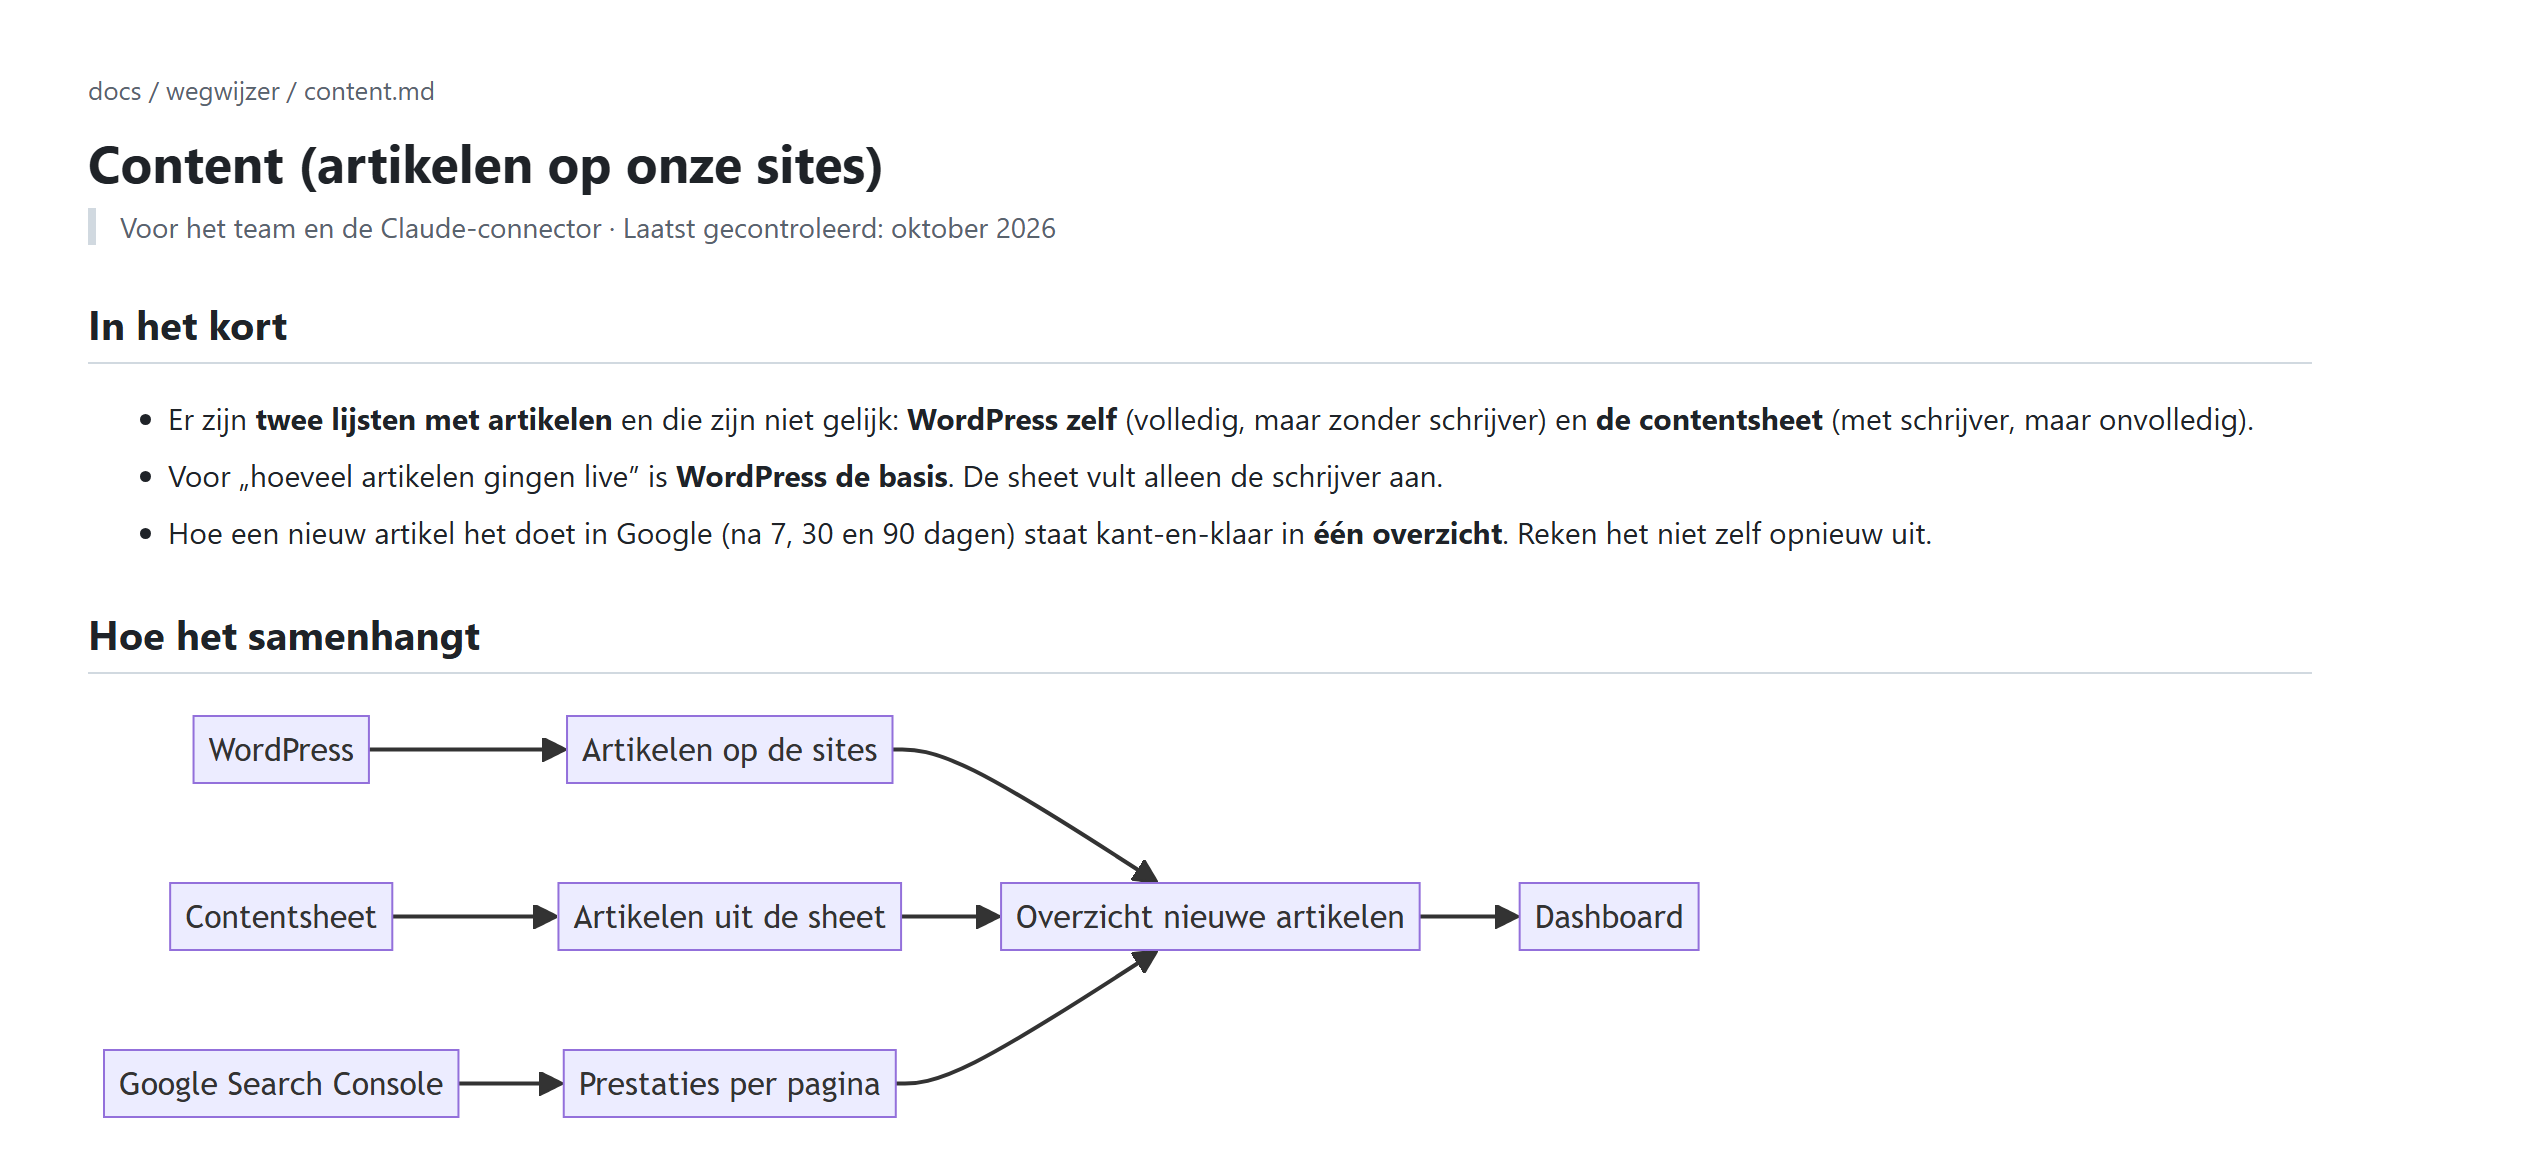
Daarna maten we opnieuw, met dezelfde vragen:
| Meting | Goed | Deels | Onvoldoende | Aanroepen per vraag |
|---|---|---|---|---|
| Nulmeting (25 vragen) | 16 | 8 | 1 | 4,6 |
| Na de omschrijvingen en de wegwijzer (25 vragen) | 24 | 1 | 0 | 2,9 |
| Na de systeempagina’s (31 vragen) | 31 | 0 | 0 | 2,3 |
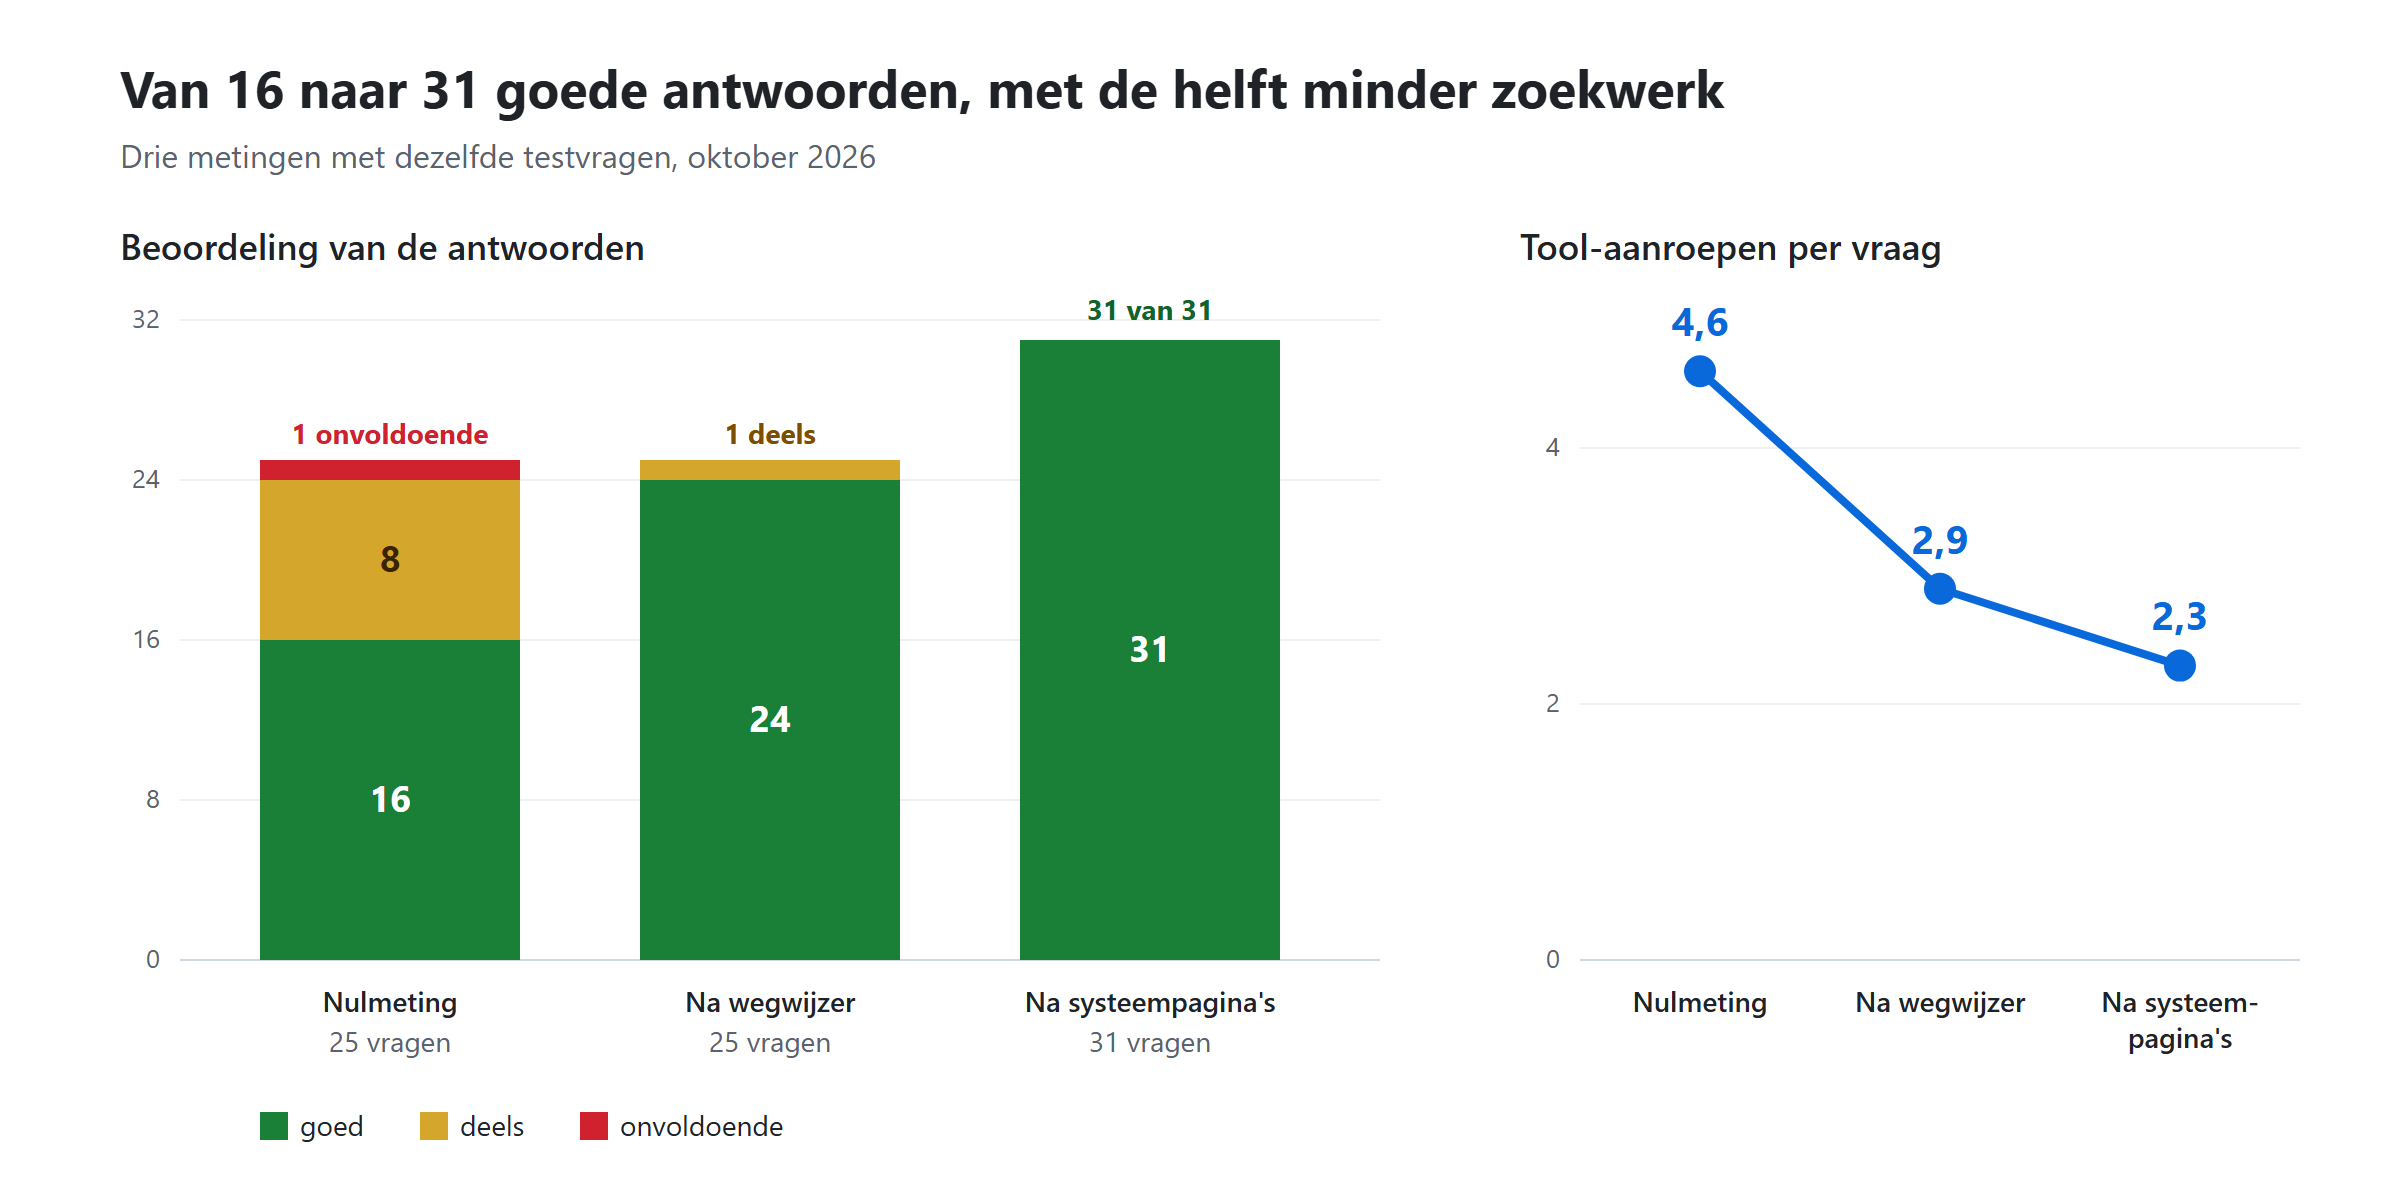
Behalve meer goede antwoorden halveerde ook het aantal tool-aanroepen per vraag. Claude hoefde minder rond te zoeken, dus de antwoorden komen sneller.
Wat er misging
Een paar dingen die we de volgende keer anders zouden doen. Juist die vind je in geen enkele handleiding.
De documentatie had zelf een fout. We beschreven hoe een status werd berekend zoals die in de oorspronkelijke plannen stond. De live database rekende inmiddels met een andere drempel. Claude zou die fout trouw hebben herhaald, met de autoriteit van “het staat in de documentatie”. Les: schrijf op wat er op productie draait, niet wat er ooit bedacht is. Controleer elke definitie tegen de live database.
Een omschrijving voor een kolom die niet bestond. Eén migratie met omschrijvingen faalde, omdat er een kolomnaam in stond die al hernoemd was. Gelukkig in een transactie, dus er ging niets half. Daarna controleerden we elke kolom eerst tegen de database voordat we iets toepasten.
Zoeken in GitHub gaf niets terug. De zoekfunctie van GitHub vond niets in onze repository, ook niet met een ander token. We lossen het nu anders op: de connector downloadt de hele repository als archief, houdt die vijf minuten vast en zoekt daarin. Simpeler en betrouwbaarder.
Stap 4: zorg dat het bij blijft
Documentatie veroudert zodra iemand een tabel toevoegt en vergeet de uitleg bij te werken. Daarom houdt onze CI (de automatische controle op elke wijziging in GitHub) een databasewijziging tegen als:
- een nieuwe tabel of view geen omschrijving heeft, of
- een kolom die naar een geheim klinkt (
token,wachtwoord,api_key…) niet is afgeschermd voor de connector.
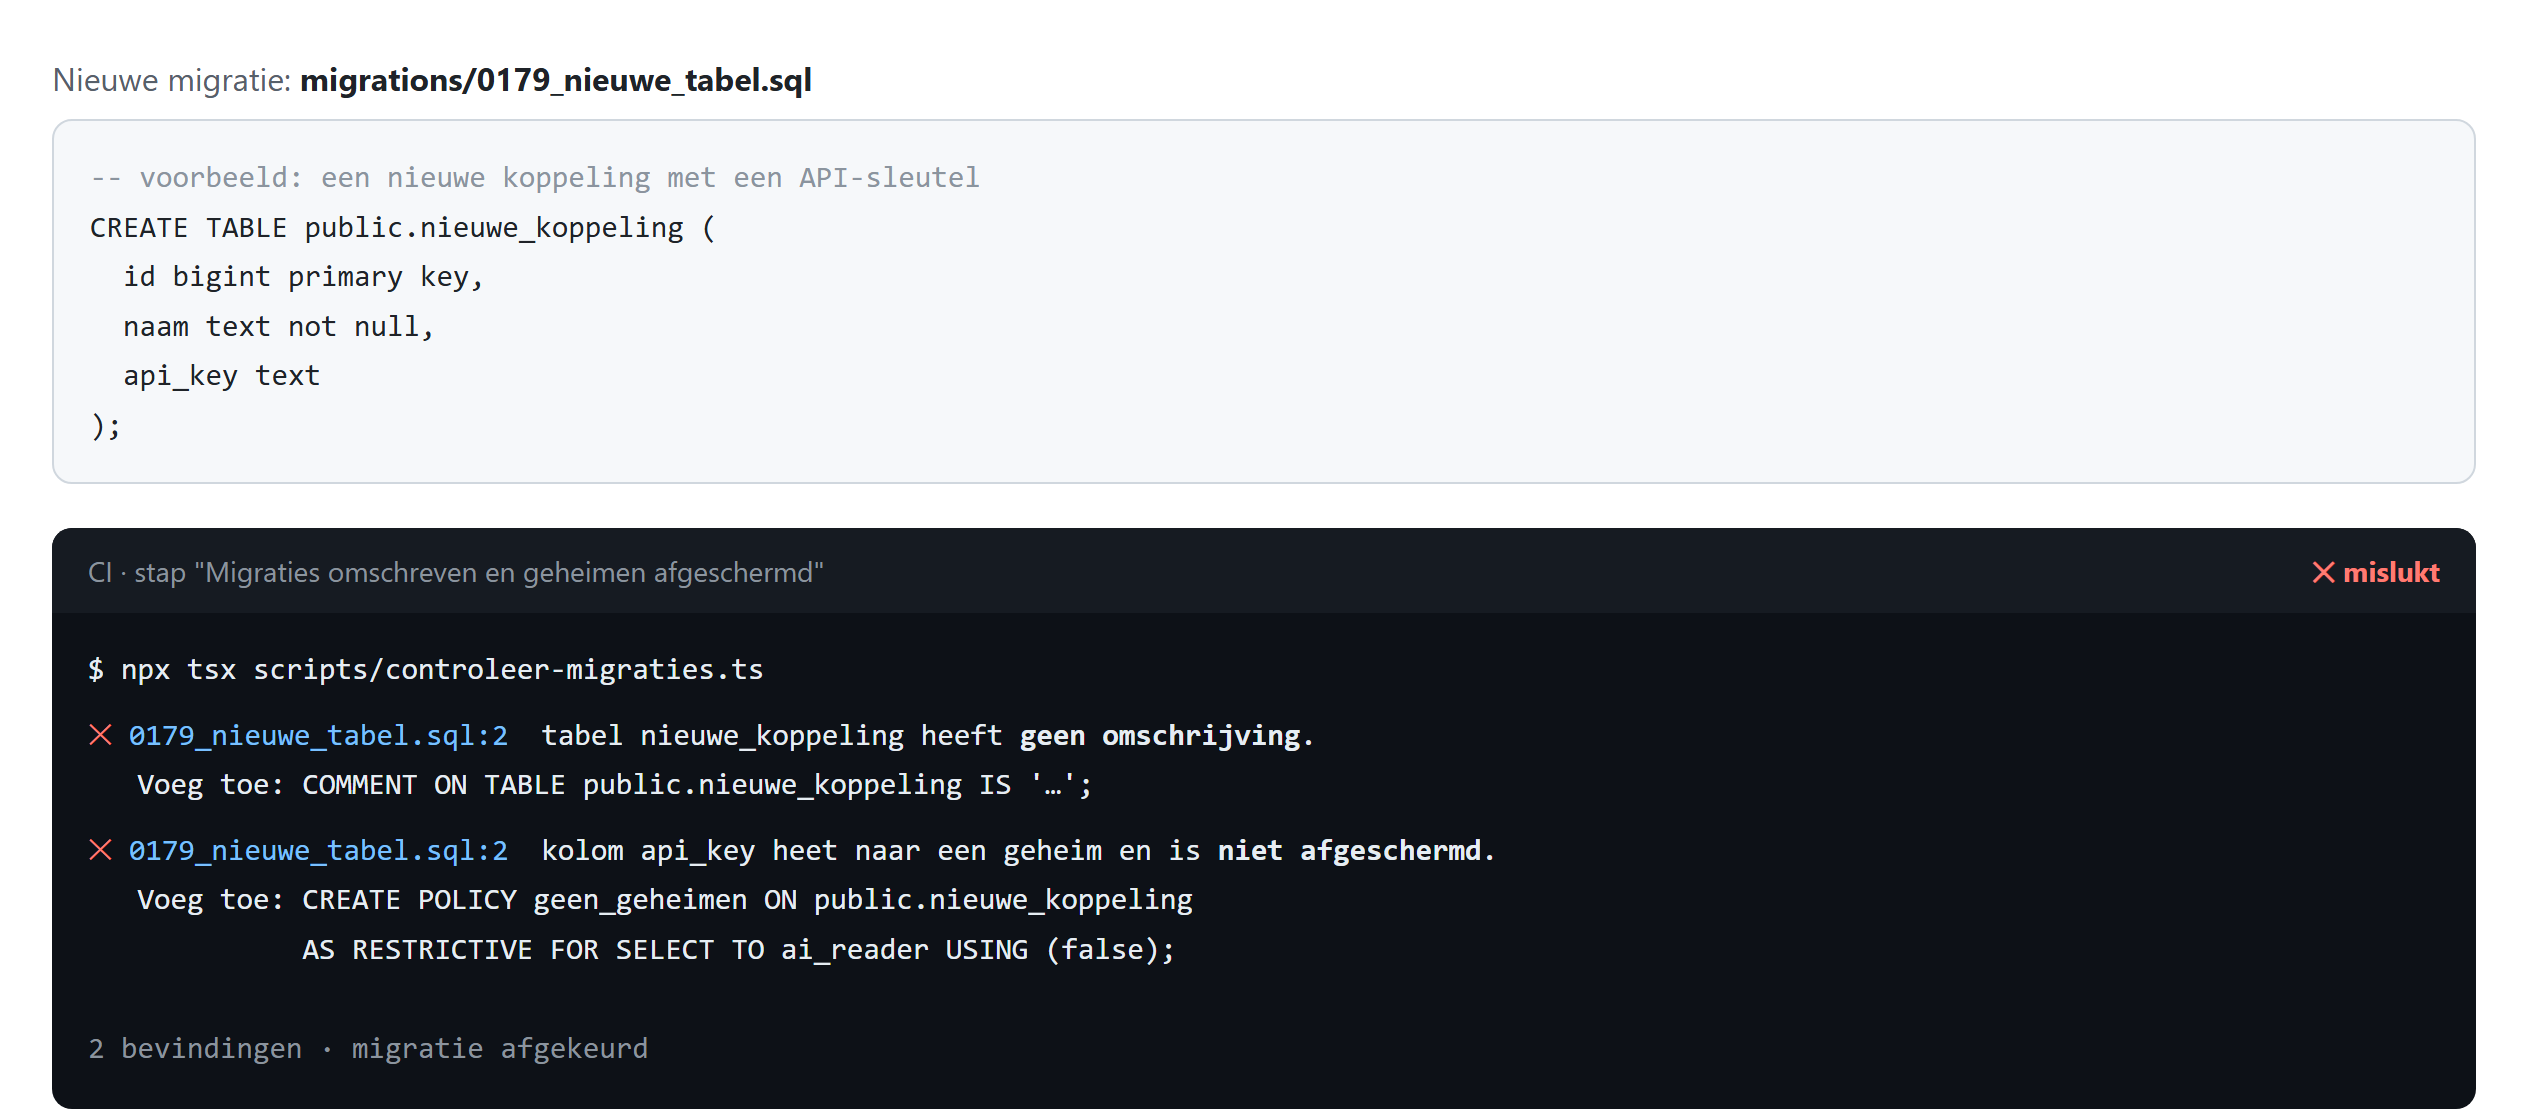
api_key, dus afgekeurd, met precies de regel die je moet toevoegen.Daarnaast controleert een dagelijkse gezondheidscheck of de connector nog bij de database en GitHub kan, en of er een token binnenkort verloopt. Fouten worden in het log gesplitst in gebruikersfouten (een verkeerde query, geen probleem) en systeemfouten (de connector is stuk, wel een probleem). Alleen die laatste geven een melding.
Wat kostte het?
- Bouwtijd: één werkdag. Twee uur voor de koppeling, vijf uur voor de documentatie en de metingen. Die verhouding zegt eigenlijk alles: het meeste werk zit niet in de code.
- Gebouwd met: Claude Code. Het grootste deel van de code en de eerste versie van de documentatie is door Claude geschreven, en door ons gecontroleerd en getest.
- Kosten: niets extra. De connector draait op wat we al hadden: onze database (Supabase), onze hosting (Vercel) en Claude Code. Geen nieuwe server, geen nieuw abonnement.
- Onderhoud: een omschrijving bij elke nieuwe tabel (afgedwongen door de CI), en na grote wijzigingen de vragenset opnieuw draaien.
Zelf doen? Checklist
- Begin met een alleen-lezen databasegebruiker. Regel veiligheid in de database, niet in de prompt.
- Zet een time-out en een rijlimiet op elke query.
- Scherm geheimen af op databaseniveau en bepaal per gevoelig veld bewust of het zichtbaar mag zijn.
- Gebruik de login die je team al heeft (OAuth), zodat je weet wie wat vraagt. Log elke vraag.
- Maak een vragenset vóór je documenteert: 20 tot 30 echte vragen uit verschillende hoeken van je team, met het juiste antwoord erbij.
- Documenteer wat je fout ziet gaan, niet alles tegelijk. Begrippen en valkuilen leveren het meeste op.
- Controleer documentatie tegen de live data, niet tegen oude plannen.
- Dwing het bijhouden af met een automatische controle.
Wanneer niet doen: als je database gegevens bevat die niet iedereen mag zien. Denk aan persoonsgegevens van klanten of lezers, maar ook aan factuurgegevens: bedragen per klant, betaalafspraken of bankrekeningnummers die niet voor het hele team bedoeld zijn. Dan is “iedereen ziet hetzelfde” geen optie, en heb je per gebruiker andere rechten nodig. Dat is een flink grotere klus, zeker achteraf. Hieronder lees je waarom.
Valkuil: rechten per rol pas achteraf inbouwen
Wij kozen bewust voor “iedereen ziet hetzelfde”. Maar wil je dat collega’s alleen hun eigen deel van de data zien, bijvoorbeeld omdat facturen alleen voor de financiële afdeling bedoeld zijn? Dan kom je bij rechten per rol. Dat is goed te doen als je het vanaf het begin inbouwt, of als je bedrijf duidelijk afgebakende afdelingen heeft. Achteraf inbouwen, in een database waarin alles door elkaar loopt, is een flinke valkuil.
Zo werkt het als je het per tabel regelt
Het makkelijke deel is er al: de connector weet wie er vraagt, want iedereen logt in met zijn werkaccount. Daarna zijn er drie stappen:
- Per rol een eigen leesrol in de database, die alleen de tabellen van dat onderdeel mag lezen.
- Een lijst die bijhoudt wie welke rol heeft, op basis van het e-mailadres.
- De connector wisselt bij elke vraag naar de juiste rol. De database weigert daarna alles daarbuiten, net zo hard als nu het schrijven.
Let op bij stap 3: bijna elke opzet hergebruikt databaseverbindingen (een “pool”). Wissel je de rol op de verbinding zelf, dan kan de volgende vraag van een andere collega nog met de rol van de vorige draaien. Wissel de rol daarom per vraag, binnen één transactie (in Postgres: SET LOCAL ROLE). Dan valt hij na elke vraag vanzelf terug. Dit is precies de fout die je niet ziet, tot er iets lekt.
Voor de lezer van de data komt het neer op twee simpele overzichten:
| Onderdeel | Tabellen |
|---|---|
| Content | artikelen, auteurs, categorieën |
| Affiliate | transacties, clicks, adverteerders |
| Financiën | facturen, betalingen |
| Gedeeld | sites, verkeer per pagina |
| Wie | Rol | Ziet |
|---|---|---|
| Redacteur | content | Content + Gedeeld |
| Affiliate-marketeer | affiliate | Affiliate + Gedeeld |
| Eigenaar | alles | alles |
Bij een handvol rollen, en zolang elke tabel netjes bij één onderdeel hoort, kost dit volgens onze inschatting een halve tot een hele dag extra.
Waar het lastig wordt
- Tabellen die bij meerdere onderdelen horen. Denk aan een omzetoverzicht met zowel affiliate- als factuurcijfers. Moet iemand maar een deel van de rijen zien, dan heb je beveiliging op rijniveau nodig. Dat betekent meer regels, meer testwerk en soms tragere vragen.
- Views kunnen lekken. Een view (een opgeslagen query) draait in Postgres standaard met de rechten van de maker. Geef je een rol toegang tot een view die facturen gebruikt, dan ziet die rol de factuurcijfers ook zonder rechten op de factuurtabel zelf. Zet views daarom op “rechten van de lezer” (
security_invoker, sinds Postgres 15) of wijs ze apart toe. Let ook op materialized views: die kennen beveiliging op rijniveau helemaal niet. - Ook de uitleg moet gefilterd worden. Laat de connector nog steeds alle tabellen en de hele documentatie zien, dan probeert Claude tabellen die hij niet mag lezen. Dat levert foutmeldingen op, en de documentatie verklapt al wat er bestaat.
- De code is lastig op te delen. In de code staat hoe alles berekend wordt, dus daar zit dezelfde informatie in. Meestal kies je: alle code voor iedereen, of de code alleen voor bepaalde rollen.
- Het onderhoud groeit mee. Bij elke nieuwe tabel moet iemand bepalen welke rol hem mag zien. Een automatische controle, zoals in stap 4, kan dat afdwingen.
- Testen wordt meer werk. Je moet per rol controleren of de antwoorden kloppen én of er niets doorlekt. Dat zijn twee vragensets in plaats van één.
De betere aanpak: één schema per onderdeel
In plaats van rechten per tabel kun je tabellen in Postgres groeperen in schema’s: aparte vakken binnen dezelfde database, zoals content, affiliate, financiën en gedeeld. Je geeft een rol dan toegang tot een heel vak in één keer, en je stelt in dat elke nieuwe tabel in dat vak automatisch dezelfde rechten krijgt. Dat lost het grootste deel van “het onderhoud groeit mee” op. De enige vraag bij een nieuwe tabel wordt: in welk vak hoort hij? Die vraag stel je toch al.
Twee alternatieven die ook kunnen:
- Per rol een aparte connector, elk met een eigen databasegebruiker. Het simpelst om te begrijpen: geen rolwissel en geen valkuil met gedeelde verbindingen. Wel heb je meerdere connectors om te beheren.
- Per rol alleen kant-en-klare overzichten (views) in plaats van de ruwe tabellen. Dan zijn die overzichten de enige deur naar de data. Dat beperkt de lekroutes en levert vaak betere antwoorden op, omdat Claude minder hoeft te raden. Nadeel: vragen die buiten die overzichten vallen, kunnen niet meer.
Ons advies: weet je nu al dat niet iedereen alles mag zien, zet je tabellen dan vanaf dag één in een schema per onderdeel en geef elke rol toegang tot de juiste vakken. Achteraf tabellen naar een ander schema verhuizen, en elke view en documentatiepagina opnieuw toewijzen, is precies het pijnlijke werk dat je wilt voorkomen.
Veelgestelde vragen
Kun je zelf een MCP-server maken?
Ja. De officiële MCP-documentatie heeft voorbeelden in onder meer Python, TypeScript en Java. Voor een interne koppeling heb je geen bureau nodig als je team al een webapp of server beheert. Het meeste werk zit niet in de code, maar in het uitleggen van je data. Wil je eerst zien wat er al bestaat? Bekijk dan onze top 10 MCP-servers voor Claude.
Kan een MCP-server je database aanpassen?
Alleen als je dat toestaat. Wij gebruiken een databasegebruiker die alleen mag lezen. Daardoor kan de connector niets wijzigen, ook niet als hij het zou proberen.
Werkt dit alleen met Claude?
MCP is een open standaard; ook andere assistenten ondersteunen het. Wij gebruiken Claude Team, omdat connectors daar voor het hele team tegelijk werken.
Hoe weet je of de antwoorden kloppen?
Door het te meten. Stel vragen waarvan je het antwoord al kent, beoordeel elk antwoord en herhaal dat na elke verbetering. Zonder meting weet je niet of je documentatie helpt.